

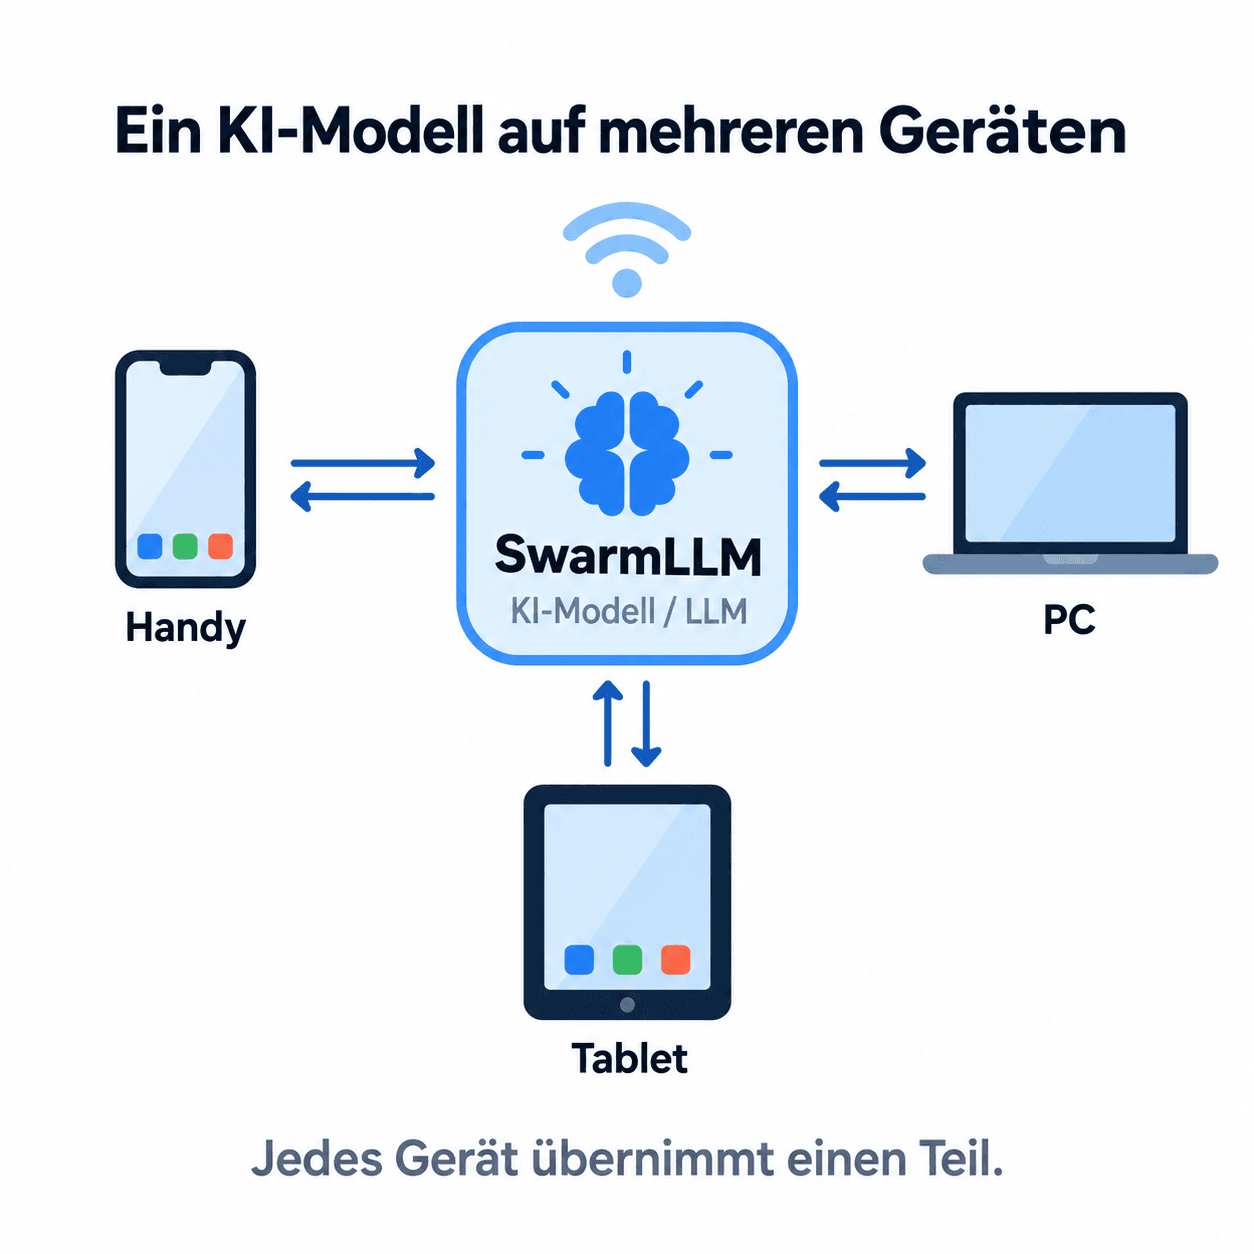
Das Projekt heißt Swarm LLM und es dreht die Frage um, an der lokale KI bei den meisten von euch scheitert. Das Problem war ja nie, dass die Modelle fehlen. Die guten Open-Weight-Modelle liegen frei zum Download bereit, die kann sich jeder ziehen. Der Knackpunkt ist der Speicher, den du auf EINEM Gerät brauchst, damit das Ding überhaupt anspringt. Ein Modell mit 70 Milliarden Parametern will je nach Quantisierung grob 40 GB am Stück sehen, und ab da wird die Anschaffung halt richtig teuer.
Swarm LLM zerlegt das Modell stattdessen in seine Schichten und verteilt die auf mehrere Geräte. Dein Hauptrechner übernimmt einen Block, der alte Zweit-PC den nächsten, das Handy noch einen. Die Geräte reden übers Netzwerk miteinander und schieben die Zwischenergebnisse hin und her, bis die Antwort steht.
Ich teste lokale Modelle und laufe regelmäßig genau in diese Grenze. Ab einer bestimmten Modellgröße ist Schluss, egal wie geduldig man ist. Insofern finde ich die Idee ziemlich charmant, weil sie mit Hardware arbeitet, die bei vielen eh schon rumliegt.
Trotzdem, und das gehört ehrlicherweise dazu, für mich ist das aktuell ein Proof of Concept. Das Projekt ist jung, es gibt kaum unabhängige Tests, und jede Schicht, die über WLAN wandert, kostet Zeit. Für einen Chat sind 10,5 Token pro Sekunde völlig okay. Für einen KI-Agenten, der dreißig Schritte hintereinander abarbeitet, summiert sich das gewaltig. Und wenn eins der Geräte in den Ruhezustand geht, steht der ganze Verbund.
Was mich daran interessiert, ist die Richtung. Lokale KI galt lange als Hobby für Leute mit zu viel Geld auf dem Konto, und dieser Zustand bröckelt gerade an mehreren Ecken gleichzeitig. Für KMU, die ihre Daten aus guten Gründen nicht in irgendeine Cloud kippen wollen, ist das keine Nerd-Spielerei, sondern durchaus relevant.
Schönen Wochenstart an alle! Gruß, Chris